2026 年 10 月 31 日,DeepSeek Harness 团队发表了《Super-agent 设计探索:迈向更自主的 Agent 系统》。文章从一个观察出发:以 Coding Agent 为代表的单任务 Agent 已经很少需要人逐步干预,但一个人通常只能同时跟进 3 到 5 个活跃 Session。原文的说法是,单任务的上限取决于模型能力,多任务的上限取决于人的注意力。
他们给出的解法叫 Super-agent:让 Agent 不再和某一次手动开启的会话绑定,变成一个跨会话保持上下文、同时推进多件事、彼此互不干扰的连续实体。文章开头写明,这是架构思路探讨,不是对 DeepSeek Harness 现有功能的介绍;部分设计放在一个原型插件里。
下面先梳理它的要点,再对照一个已经上线的多人多 Agent 产品,看哪些已经做到、哪些还差。
Super-agent 的四个特征
文章认为,单个 ReAct 循环撑不起这四点,需要五个模块。
五个模块,和 Agent.Space 的对照
1. 双层架构:一个入口,多处并行
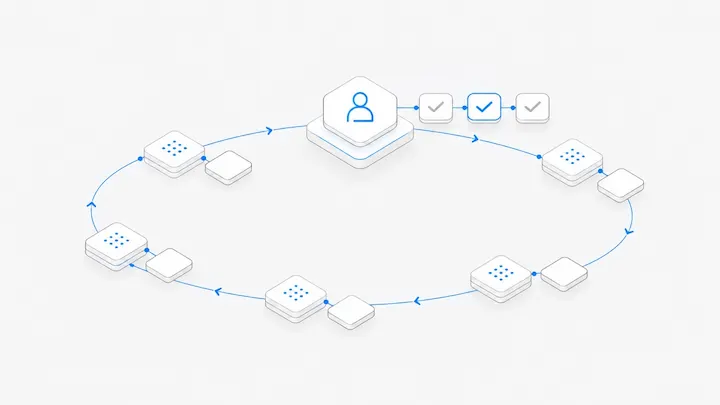
DeepSeek 的设计:常驻的 Router 层统一承接所有入口的人类交互,只负责分派,不直接执行,甚至可以不配 Bash 工具。Worker 层由上下文隔离的会话组成,各自专注一件事,向 Router 汇报,再由 Router 统一回复用户。
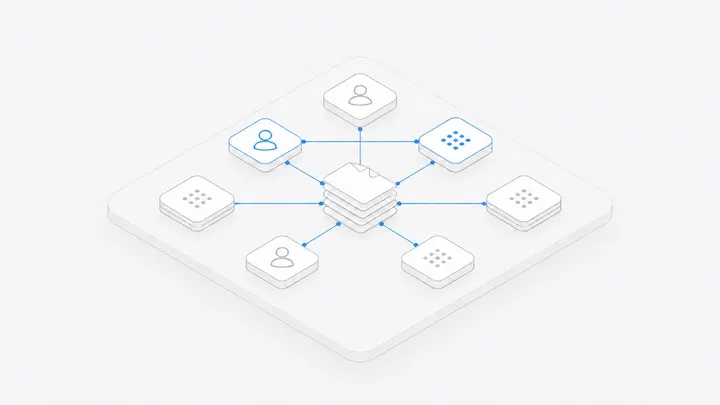
Agent.Space 的做法:每个成员有自己的 Ghost。在全员讨论里 @Ghost,叫到的是你自己那个:可以问进展、问谁在等谁,让它开一个对话交给 Claude Code 或 Codex。Ghost 默认在云端随时在,也可以放到你自己的电脑上,用你的 Claude Code 或 Codex 亲手干活。具体干活的是一个个对话,每个对话配一个 Agent,有自己的上下文,同一工作空间里的对话可以并行。
两边的区别在于对话是否可见。DeepSeek 希望把 Session 藏进系统内部,用户只面对一个 Agent;Agent.Space 把每个对话留在明处,成员可以点进去看、接着发任务。原因在后面一节。
2. 事件驱动:Agent 自己发现该做的事
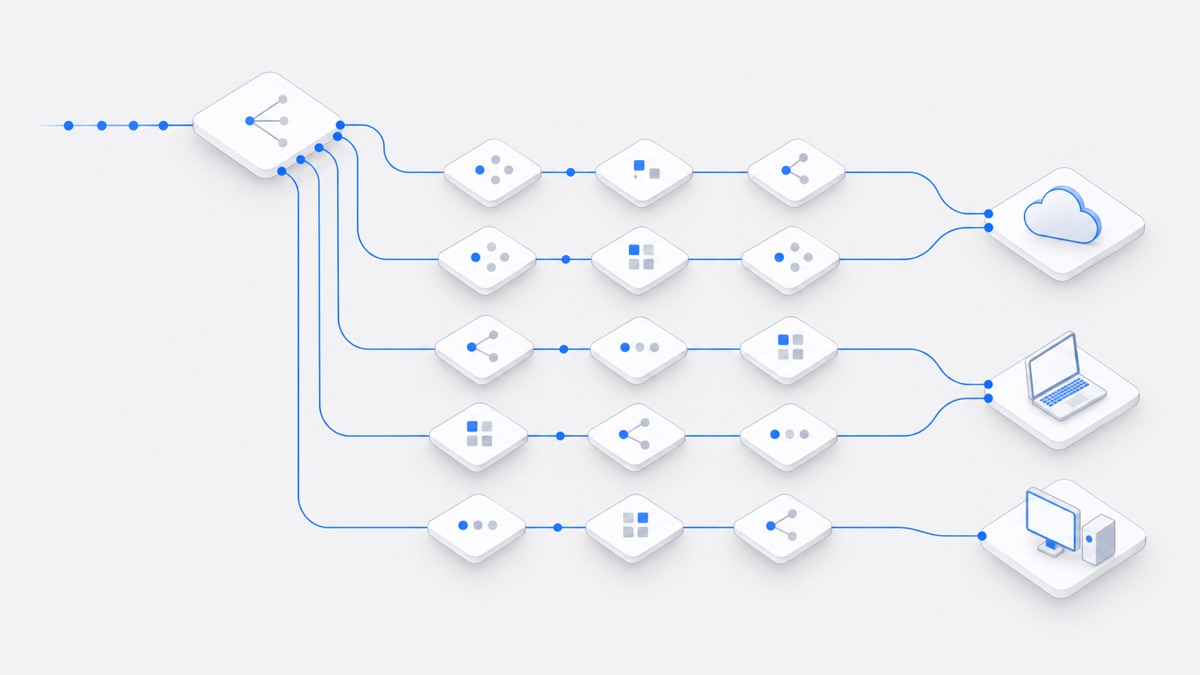
DeepSeek 的设计:驱动 Agent 的,换成了群聊消息、邮件、日程、代码评审、CI 结果这类事件(Trigger),不再靠人逐条输入提示词。先用程序规则过滤噪音,再交给模型判断;同一个 PR、同一个话题下的后续事件,直接送给已经接手的 Worker;还可以在后台先试着复现、修复问题,有了结果再告诉人。
Agent.Space 的做法:云端工作空间有定时任务,可以按时间让 Agent 开工;云端的 Ghost 可以到点提醒。群聊、邮件、GitHub、CI 这类外部事件,目前还不能直接触发对话。这是 Agent.Space 和 Super-agent 设想差得最多的一块。
3. 面向人的交互:不阻塞,按渠道说话
DeepSeek 的设计:把耗时的工具调用改成异步,Agent 在后台跑任务时也能接新消息;在 IM 里简短(他们验证过的一条规定是单次回复不超过 100 词),在 GitHub、邮件里写结构化的长内容。
Agent.Space 的做法:一个对话正在忙时,新消息进入大家都看得到的队列,成员可以调整顺序,这一轮结束后按顺序发出;要同时推进别的事,就开新对话,它们互不阻塞。入口有网页、Mac 和 Windows App;Claude Code、Codex、Cursor 可以通过 MCP 连接工作空间;外部 Agent 可以通过 A2A 协议在连接的工作空间里开对话、续聊、查结果。单个对话内部还做不到边跑边接新消息。
4. 计算、状态和执行环境分开
DeepSeek 的设计:推进 Agent 的计算放进云端的无状态容器,会话状态存进数据库;代码仓库、本地凭据、内网依赖这些执行环境留在原处,只在设备上装一个轻量 daemon 执行命令。这样 Agent 不受单台电脑开关机的影响,也能接入用户自己的电脑,原文称为 BYOM(Bring Your Own Machine)。
Agent.Space 的做法:对话、文件和成员存在工作空间里,关掉浏览器不会丢。Agent 可以在三种电脑上工作:按需启动、空闲休眠的云端电脑;装了 Mac 或 Windows App 的成员电脑,用这台电脑上的文件、登录和订阅;单独订购的独享 Mac。成员电脑的主人决定这台电脑只给自己用,还是开放给其他成员。
5. Watchdog:系统外面的看门人
DeepSeek 的设计:在主系统之外放一个独立的 Watchdog 会话,用定时消息驱动,检查各个 Worker 有没有实质进展、方向是否偏离,发现问题就介入;维护者还可以用自然语言问它故障原因。
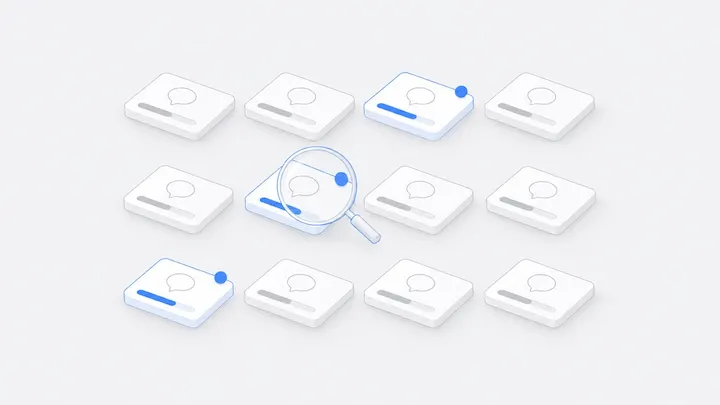
Agent.Space 的做法:没有单独的 Watchdog Agent。进度从几个地方浮出来:列表上的蓝色数字和地图上的「等你」,标出等你批准、等你回复、结果还没看的对话;动态视图的地图标出在跑、等批准、卡住的对话。方向偏没偏,目前还靠人判断。
一个分歧:会话该不该藏起来
DeepSeek 认为,让用户手动管理 Session,很大程度上是从底层 LLM API 延续下来的习惯,Session 应该是系统的实现细节。Manus 的 hidecloud 在《用 Manus 改造 Manus》里写的几乎相反:Session 本身会成为多人协作的工作对象,一个人提出问题、设计师出方案、工程师实现、产品经理继续运营,都可以在同一个 Session 里推进。
两种看法对应不同的使用者。只有一个人时,少管几个会话当然更省心。在一个团队里,人要检查 Agent 做了什么、中途接手、在关键处批准,这些动作都需要一个看得见、进得去的对象。所以 Agent.Space 两层都留:每个人的 Ghost 做入口,底下每个对话都能被看到、被接手。几个人怎样共用一个对话,见这篇说明。
文章留下的三个开放问题
离开聊天窗口以后,怎么和 Agent 协作
原文认为,以聊天窗口为中心的交互有路径依赖,交互可以更多发生在 GitHub Issue、PR 这类领域界面里。Agent.Space 现在的做法是把很多对话放到一张地图上:按分组铺开、标出状态,再用「等你」把该你处理的事挑出来。直接在 GitHub 里和 Agent 协作,还没有做。
上下文边界和 A2A
原文说,组织决定怎么配备 Super-agent,实际上是在划分上下文共享与隔离的边界;边界之间的协作就是 Agent 之间的通信。在 Agent.Space,一个工作空间就是这样一条边界,成员、文件和对话在里面共享。外面的 Agent 由成员授权连接后,通过 MCP 或 A2A 在选定的工作空间里工作。
安全和隐私
原文提醒,云端的 Agent 连着用户的设备,一旦被攻破,所有连接的设备都有风险;凭据也不应该进入模型上下文。Agent.Space 用工作空间角色限制谁能发任务、谁只能看;成员电脑上的 Agent 别人能不能用,由电脑主人决定;发任务的人选权限模式,操作也由他自己批准,电脑主人不能替他批准;所有者接入的模型 API Key,成员能用但看不到。任务如果用「全部允许」或完全访问的模式发出,运行命令、联网和改动文件夹外的文件都会直接执行,发之前要看清模式。
想试一试
- 创建工作空间,开两三个对话,分别选 Claude Code、Codex 或 DeepSeek Harness。
- 在全员讨论里 @Ghost,问一句「现在谁在等谁」,或者让它开一个对话交给 Codex。
- 想让 Agent 用你电脑上的文件,装上 Mac 或 Windows App,把这台电脑接进工作空间。
- 第二天先看「等你」,处理等你批准、回复和验收的对话。
DeepSeek Harness 在 Agent.Space 里怎么评估,见这篇说明。多人多 Agent 协作的整体概念,见多人多 Agent 协作是什么。
常见问题
Super-agent 和 Agent Team、子代理有什么区别?
按 DeepSeek 原文的说法,常见的 Agent Team 用来拆解单个复杂任务,Team Lead 要深入理解任务细节、高频协调各个成员,推理负担很重;Super-agent 的 Router 只处理任务之间的关联和分派,不介入单个任务内部。一个 Worker 内部仍然可以再开子代理,或者本身就是一个 Agent Team。
Super-agent 现在能直接用吗?
DeepSeek 说明,文中部分设计已在一个原型插件里实现,用来验证技术路线,不是 DeepSeek 的正式产品。想在团队里试,先放在不含敏感数据的测试项目里。
只有一个 Router,会不会忙不过来?
原文做了压力测试:需要决定的事件从每分钟约 1 条升到约 40 条时,Router 平均每批处理的事件从 1.0 条增加到 2.8 条,单次请求耗时只从 2.5 秒增加到 3.9 秒,摊到每个决定上的时间反而从 6.4 秒降到 1.6 秒。原因是积压的事件会合并进下一次调用一起处理。他们的结论是,在现有团队规模下还不需要把 Router 拆开。