每个月花 200 美元订阅 AI,到底能用到多少东西?
官网通常告诉你“更多用量”“20 倍额度”,很少把它换成一张能和 API 账单直接对照的表。对每天让 Agent 读仓库、改代码、跑测试的人来说,这个问题很实际:同样的月费,哪家能让工作多推进一些?
@kunchenguid 在 X 上分享的一次测试给出了一个少见的切口。他使用自己的真实订阅,在干净环境中反复运行开源仓库评测任务,分别消耗各家 5 个百分点的额度,记录 Agent 会话的 Token 用量,再按 API 标价折算。
结果很醒目:SuperGrok Heavy 的满额月度折算值约为 12,000 美元;200 美元档的 ChatGPT Pro 和 Claude Max 都在 7,000 美元上下;Cursor Ultra 则是 3,400 美元。
这足以让人重新看一眼订阅账单。不过,在决定续费哪家之前,还得弄清这些钱是怎样算出来的。
四款订阅,四笔账
下面保留原作者的数据。月度数值来自他对样本的外推,假设编码 Agent 额度能够全部用完;Agent.Space 没有独立复测,也没有拿到逐次调用日志。
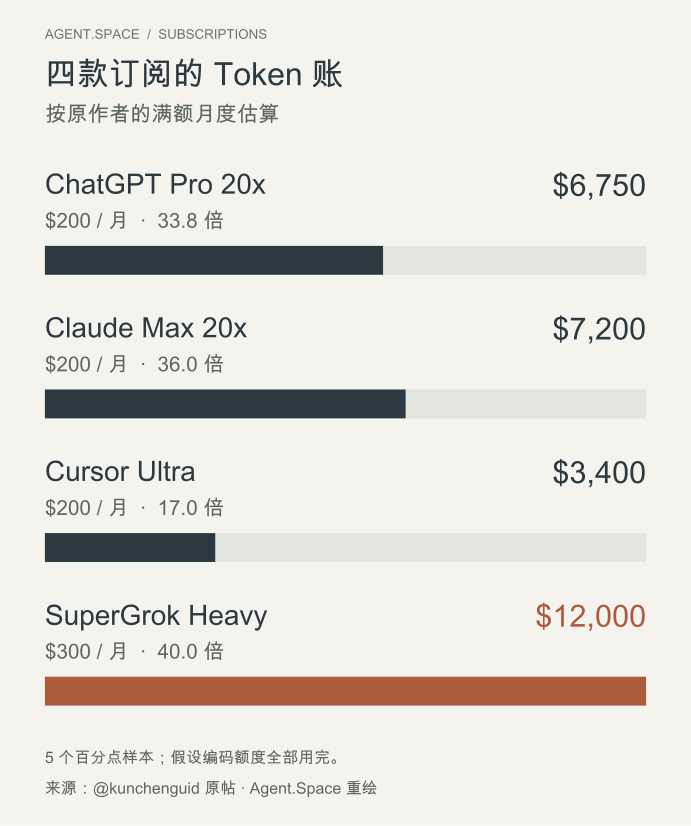
数据来源:@kunchenguid 原帖;Agent.Space 重绘。图中是作者报告的估算值,不是厂商承诺的 API 余额。
只看这张表,SuperGrok Heavy 同时拥有最高的折算总额和倍数。Claude Max 比 ChatGPT Pro 高约 6.7%,两者在同一量级;没有重复测量和误差范围,没必要把这点差距读成稳定的胜负。Cursor Ultra 的折算额约为另外两款 200 美元套餐的一半,这个差距值得认真核对自己的使用情况。
套餐名称里的“20x”也有各自的参照物。OpenAI 对比的是 ChatGPT Plus,Anthropic 对比的是 Claude Pro;它们和表格最后一列的折算倍数是两套计算。
40 倍的折算值,能兑现多少?
这里的算法可以写得很简单:按 API 标价计算的同类 Token 用量费用,除以订阅月费。 12,000 除以 300,得到 40。
原帖把这个比例称为 ROI。为了方便读者用它做预算,本文称它为“API 标价折算倍数”:它衡量的是套餐里用量的标价面额。省下多少钱,还取决于你原本会不会付钱使用这些用量。
举个假设。你每月确实有一批工作,按合适的 API 路径完成要花 300 美元;某个 200 美元的订阅能在相同验收标准下完成它,也没有额外费用,那么可以比较的账面节省是 100 美元。反过来,如果你的实际需求每月只值 60 美元 API 用量,200 美元订阅需要靠编辑器、聊天或其他功能补上剩余价值。再大的满额折算数字,也不会自动替你省钱。
这张表同样不能用来推算厂商“每个用户亏了多少钱”。API 零售价和服务商的实际推理成本是不同的账目,单凭前者推不出后者。
Token 的标价,会改变排行榜
API 美元是一个方便的换算单位,但它仍受模型价格影响。
假设两个模型都完成了同一项修改,产物同样合格,其中一个模型每个 Token 的标价更高。按这张表的算法,它消耗同样数量的 Token 就会产生更大的折算值。结果中既有订阅给了多少用量,也有这些用量被定了多高的价格。
缓存又会把差距拉开。Agent 一轮轮工作时,经常会再次带上仓库文件、工具说明和已经读过的上下文。新输入、缓存读取、缓存写入、输出的费率可能相差很大。把所有输入都按新输入价计费,和按照真实缓存记录计算,得到的账单可能完全不同。需要自己核账时,可以沿用这份 Coding Agent API 成本计算方法。
原帖的文字和图片没有给出完整的模型版本、推理设置、缓存构成、逐次日志或各家重置窗口的月度换算过程。因此,这些数字适合用来发现值得测试的套餐,还不足以复算出一个人人适用的月度额度。干净环境有助于控制干扰,但不会让不同模型、harness 和额度机制自然变得相同。
还有一个更贴近工作的区别:Agent 多读几遍文件、多试几次错误方案,都会消耗 Token。折算表会把它们加进去,交付清单却只会留下最后通过验收的修改。用量大,和少返工,是需要分别观察的两件事。
最容易被忽略的,是用不完
40 倍成立的前提,是把对应编码额度完整用掉。
沿用原作者的估算,并假设任务、模型和缓存比例都不变,SuperGrok Heavy 如果只用到满额的四分之一,折算值就是 3,000 美元,对月费的倍数降到 10 倍。Claude Max 用到四分之一,则是 1,800 美元、9 倍。这只是展示利用率如何影响结果的算术例子,不能用来预测账号还剩多少次任务。
利用率还受到工作节奏影响。一个月中的大多数时候用得很少,在交付前两天突然需要大量 Agent 工作,总额度看着充裕,也可能碰到短周期限制。例如,Anthropic 的 Max 说明同时列出了五小时会话额度和每周额度。月费按月收取,并不代表所有容量都能集中在某一天使用。
原作者也明确排除了普通聊天、Grok Bot 等编码额度以外的价值。经常使用这些功能的人,需要把自己的受益加回去;只做编码的人,则可以更专注地比较这部分用量。两种用户看到同一张表,完全可能作出不同选择。
Cursor Ultra 还值不值得买?
原作者据此认为,Cursor Ultra 对个人消费者已经不太值得购买。对于把大部分预算花在第三方编码模型、又经常耗尽额度的人,这个判断提出了一个很直接的问题:同样每月 200 美元,为什么接受大约一半的 Token 折算值?
要回答它,得把自己在 Cursor 中实际用的功能展开。Cursor 的当前计费文档把 Cursor Models 和 Other Models 分成两个按月重置的用量池,后者按对应模型的 API 价格消耗额度。它还包含编辑器里的 Tab 补全等能力。原帖没有交代这两个池分别测了多少,读者不应把一个总数套到所有模型组合上。
如果你使用 Cursor 主要是因为编辑器里的修改和审阅方式顺手,额外价值就来自日常工作少花的时间。可以记录一周:完成相近任务时,需要多少人工修改,有多少次上下文切换,有没有撞到用量限制。先看这几个数字,再决定这个编辑器值得配多高的用量档。
反过来,长期把它当作第三方模型调用入口、很少用到编辑器优势的人,确实有理由比较原生订阅或更低档位。也可以结合 Codex 与 Cursor 的工作流对比,把运行入口和计费方式一起判断。
把自己的账补进去
准备购买或续费时,拿上个月的真实工作问三个问题就够了:
- 我到底用掉了多少? 记录活跃天数、常用模型和限制出现的时间。不要为了提高利用率,专门制造自己不需要的任务。
- 这些工作完成得怎么样? 比较能通过同一套检查的结果,同时记录重试和人工修补。失败任务的花费也要算进去。
- 我需要为剩下的功能付多少钱? 编辑器、聊天、研究、图片和协作各有用途,把你确实使用的部分算进预算。
如果需要比较更广的订阅、包含用量与超额费用,可以继续看 AI Coding Agent 价格对照。换到另一个工具前,也先确认项目和工作流能否方便地继续。Agent.Space 的 Workspace 与交接机制解决的是项目持续协作的问题,它使用独立的模型访问与计费路径;上表里的官方订阅额度不会因此转入 Agent.Space。
还有一条会直接影响购买的更新:截至 2026 年 9 月 15 日核对时,OpenAI 自 9 月 10 日起暂停了 ChatGPT Pro 200 美元档的新购和升级,现有订阅继续正常续费。 如果取消或降档后该订阅已经结束,暂停期间不能重新买回。下决定前应阅读 OpenAI 的最新说明。Anthropic 的 Max 20x与 Cursor Ultra网页月费在本次核对时均为 200 美元;表内 SuperGrok Heavy 的 300 美元沿用原帖价格,实际购买以账号结算页为准。
这份测试最有用的地方,是让藏在“20x”和“更多用量”后面的容量差异变得可讨论。它值得放进购买决策里,再加上你的实际需求、工作节奏和交付结果。每月固定花出去的那笔钱,最终要由完成的工作来解释。
本文参考 @kunchenguid 的原帖与配图,并补充官方资料和计算分析。原始测试数据归原作者;示例计算不代表独立实测。官方资料核对日期:2026 年 9 月 15 日。